NVIDIAの予想PER16倍を問い直す Pt.1:推論への転換とGPUのNPU化で揺らぐCUDAの競争優位
 コンヴェクィティ
■利益倍率の低下と競争力
NVIDIAの今後12カ月の予想PERは約16.5倍で、2015年以来の水準。筆者は低い評価倍率が競争優位の縮小を映していると考え、倍率だけで機会と判断する見方に疑問を呈します。
■推論へ移る計算の重心
事前学習に加え、強化学習用の出力や思考トークンの生成が拡大しています。筆者は計算の大半が推論へ移ることで、CUDAの柔軟性が守る仕事の割合は縮小すると考えています。
■GPU内部の配分が逆転
Tensor Coreは独自のメモリや命令を持つ行列演算エンジンへ進化しました。筆者の推計ではBlackwellの計算用シリコンの約3分の2を占め、GPUのNPU化が進んでいます。
■構造の類似が移植を助ける
NVIDIAは低精度の行列演算へ資源を振り向け、競合のAI専用チップに近づいています。実行時の制御には違いが残るものの、筆者は構造の共通化がCUDAの防御力を弱めると見ます。
※本稿は、NVIDIAの評価倍率と競争優位を検証するシリーズのPt.1です。Pt.2では、AIによるコード移植、Broadcomのカスタム半導体と光通信、企業のAI導入が競争に与える影響を取り上げます。
1. 予想利益倍率の低下は何を意味するのか
NVIDIA(NVDA)と同社の競争優位について、改めて考えたいと思います。PERが15倍前後だからNVIDIAの評価には余地がある、という声を繰り返し耳にします。株価約230ドルでは、2028年度の市場予想利益に対して14.5倍です。今後12カ月の利益に対する倍率は約16.5倍と、2015年1月以来の最低水準にあり、過去15年間の平均約30倍を下回っています。テクノロジー投資家にとっては低い評価に映り、複数の著名な投資家がNVIDIAへ資金を投じています。しかし、低い評価に見えても業績や競争力が悪化し、期待する価値が実現しない「バリュートラップ」のリスクもあります。議論の核心は、NVIDIAがその罠なのか、それともテクノロジー分野で価値の再評価につながる機会なのか、という点です。
強気派はいくつかの根拠を挙げていますが、その多くはNVIDIAの評価倍率がいかに低く見えるかという話に戻ります。私たちは強気派と弱気派の双方の主張を検討し、それぞれに自分たちの見方を照らし合わせたいと考えています。これを、市場・ウォール街・私たちの見方を比較するMSUの枠組みでまとめていきます。NVIDIAに初めてこの枠組みを適用したのは、2023年12月の分析でした。NVIDIAの競争優位と、一見低く見える評価が本当に妥当なのかを、より的確に判断するためです。
利益倍率を読む際の前提
【補足】予想PERと競争優位
予想PERは、株価を将来の1株当たり利益の予想で割った倍率です。本文の14.5倍は2028年度、16.5倍は今後12カ月と、利益の対象期間が異なります。倍率の低下だけでは、将来の利益が維持できるか、競争力が変化しているかまでは判断できません。
2. 事前学習から追加学習・推論へ
計算需要の中心が変わる
まず検討したい変化は、事前学習から、その後に行う強化学習への移行です。私たちは、これを大きな枠組みの転換だと考えています。ChatGPTが登場した当初、計算資源の大半は学習に使われていました。おおむね80%が学習、20%かそれ以下が推論という配分です。以前のNVIDIAのMSUレポートで、私たちはいずれ計算の大半がさまざまな形の推論へ移ると予測し、その見通しは的中しました。当時、「AIチップへの需要は、参入障壁の低い推論向けがますます増えていく」と記しました。
現在、計算量を拡大するというのは、事前学習の計算量を増やすことだけではありません。最初の学習の後に行う強化学習を含め、追加学習に使う計算量も増やしています。モデルの学習に使われる計算のうち、追加段階の強化学習が占める割合は拡大しています。さらに、利用時点で行う学習や推論もあります。詳しくは、昨年のDeepSeekとKimiの分析をご覧ください。
推論モデルには、さらに別の層があります。計算の多くが最終回答そのものではなく、途中の思考に使われます。最終回答の1トークンに対し、思考用のトークンを10個生成するモデルもあるでしょう。これらを合算すると、大きな変化が見えてきます。将来、事前学習が計算全体に占める割合は20%未満になるかもしれません。残りの大半は、追加の強化学習に用いる出力の生成、思考用トークンの生成、利用者に見せる最終回答の生成など、さまざまな形の推論になると考えています。こうした二つの傾向は、すでにデータにも表れています。2月にCursorは、Composer 1.5の追加学習に使った計算量が、基盤モデルの事前学習の計算量を上回ったと述べました。5月にはGoogleが、月間で3,200兆超のトークンを処理していると発表しました。1年前の約7倍です。
【補足】学習と推論は用途だけで分けきれない
学習はモデルの内部の重みを調整し、推論は学習済みのモデルを動かして出力を得る処理です。ただし、強化学習のための候補回答を作る際にも推論を行います。本文が述べる「推論の拡大」には、利用者への回答だけでなく、学習を支える出力生成も含まれます。
CUDAが守る計算領域は縮小する
以前のNVIDIAのMSU分析で論じたとおり、同社にとって最大の競争優位はCUDAです。学習は複雑で変化も速いため、CUDAのプログラミングの柔軟性が欠かせません。これが、競合には容易に追いつけない深い防御壁を築きます。一方、推論では追いつきやすく、競合はすでに追いつきつつあると私たちは考えています。2023年12月には、「推論用ASICは容易だが、学習用ASICは極めて難しい」と、率直に表現しました。
計算の比重が推論へ移るほど、CUDAの競争優位は縮小すると考えています。これは以前から予想していたことで、2023年には、トランスフォーマーの構造が固まるにつれ「CUDAの防御壁は迂回される」と書きました。その後変わったのは、計算需要の内訳です。学習が中心だった時代、CUDAは当時の表現で「さらに深くなりつつある深い防御壁」でした。計算の大半が推論に移ると、その深さが守る仕事の割合は小さくなります。私たちはこの傾向が続くと予想しており、NVIDIAにとって重大な問題だと見ています。
3. 推論需要の拡大と計算の同質化
専用チップで担いやすい仕事
2023年12月に書いたことを振り返ってみましょう。私たちは、カスタムASICが本格的に広がり、膨大な推論需要が計算市場全体を占めるようになると予測しました。推論については、「モデルの構造が固まり、明確に定義されているため、それに合わせたASICを設計するのは非常に容易だ」と記しました。モデルの学習が終わると重みは固定され、毎回同じ計算を実行します。そのため、学習に必要な柔軟性を持たせず、その仕事に特化したチップを作れます。
この推論需要を担うのは、NVIDIAのGPU、アルファベット(GOOGL)傘下GoogleのTPU、ファーウェイのNPUのいずれに組み込まれていても、行列演算を担うコアです。計算の本質は同じで、行列演算に、少量のベクトル演算とスカラー演算が伴います。この観点から見ると、役割は非常に同質化し、汎用品に近づいています。誰もが同じ計算能力を販売するようになることは、NVIDIAにとって問題になり得ます。
【補足】ASIC・NPU・TPUと計算の種類
ASICは特定の用途に合わせて設計する半導体です。NPUはニューラルネットワーク向けの処理装置、TPUはGoogleのAI向け処理装置です。行列は数値を縦横に並べたもの、ベクトルは数値の列、スカラーは一つの数値を扱います。名称が違っても、AIで繰り返す主要な計算が似ていれば、設計の共通点は増えます。
4. 汎用GPUの「NPU化」
柔軟性と計算密度の交換条件
最も興味深いのは、私がGPUの「NPU化」と呼ぶ変化です。これは広く誤解されています。多くの人が、GPUは計算を高速化でき、さまざまな用途にも広く使えるから特別だという説明を、内部構造を十分に理解しないまま受け入れてきました。私たちの率直な、あるいは大胆ともいえる結論は、NPU化はすでに起きているというものです。GPUがファーウェイのNPUやGoogleのTPUのようなAI向けASICに近づくことで、GPUの競争上の強みは徐々に小さくなっています。
NVIDIAのGPUにTensor Coreが導入される前は、構造の大半を汎用のCUDAコアが占めていました。ほぼあらゆる計算を実行できる、プログラム可能なコアです。この時代には、NVIDIAに大きな優位性があると本当に言えました。CUDAコアはCUDA言語と結び付いており、他の半導体メーカーにとって、NVIDIAのGPU向けに設計された既存のCUDAプログラムやソフトウェア群を、行列演算コアを中心とするカスタムASICへ移植するのは極めて難しかったのです。基礎となる構造があまりにも異なっていました。
私たちが予想したとおり、同じ計算能力をより低コストで販売する圧力が、NVIDIAを別の方向へ向かわせています。理論上、同じチップ面積では、プログラムの柔軟性と搭載できる計算能力の間に交換条件があります。柔軟性を高めると、その面積に詰め込める計算能力を犠牲にします。同じシリコンで計算能力を最大化するなら、柔軟性を犠牲にします。NVIDIAのGPUでは、これがCUDAコアとTensor Coreへの配分に表れます。CUDAコアは柔軟性を担い、Tensor Coreは計算能力を担います。後者の仕事は行列の掛け算に絞られますが、1平方ミリメートル当たりで実行できる量ははるかに多くなります。以前のNVIDIAは柔軟性を重視していたため、競合は計算密度を最大の訴求点にできました。同じ金額でより多くの計算能力、より多くの収益、より良い投資効率を提供できる、というわけです。
Tensor Coreが補助装置から主役へ
Tensor Coreの仕事は一つです。行列と呼ばれる二つの小さな数値の格子を掛け合わせ、その結果を累積値に加える処理を、一度に実行します。この行列乗算が、AIの算術処理の大半を占めます。モデルの各層は、入力に学習済みの重みを並べた大きな行列を掛け、出力に変えます。この処理を何十億回も繰り返します。CUDAコアは積和演算を一つずつ進めますが、Tensor Coreはそのまとまりを一度に処理します。NVIDIAがチップ内に繰り返し配置する構成単位であるSMの内部で比べると、1クロック当たりのTensor Coreの仕事量は、CUDAコアに対してVoltaで8倍、AmpereとHopperで16倍、Blackwellで32倍となりました。
SM内部で変わる役割
補助装置から専用エンジンへ
Tensor Coreは、規模だけでなく性質も変わりました。2017年のVoltaで導入された当初は、SM内の補助装置であり、CUDAコアと同じレジスターからデータを受け取り、同じスレッドで動かされていました。それ以降、世代を重ねるごとに大きく、速く、自己完結した装置になっています。Turingでは整数形式を追加し、Ampereでは新しい数値形式と、背後でデータを読み込む仕組みを導入しました。Hopperでは専用のデータ移動エンジンを与え、共有メモリから直接データを受け取り、はるかに大きなまとまりを処理できるようにしました。BlackwellではTensor Memoryという専用メモリを持ち、単一のスレッドが一つの命令で約50万回の積和演算を開始でき、その処理を二つのSMにまたがって実行できます。CUDAコアの付属品だったTensor Coreは、独自のメモリ、データ供給、命令を持つ行列演算エンジンへ変わりました。NPUやTPUの中心にある行列演算エンジンによく似ています。
【補足】SMと積和演算
SMはGPU内で計算を実行するまとまりで、その内部にCUDAコアやTensor Core、制御回路、メモリがあります。積和演算は、数値を掛けた結果を別の数値に足す処理です。コアの個数、コアが占める面積、一定時間にこなす計算量は、別々の指標として読む必要があります。
世代別の面積配分が示す変化
競合に追いつくため、NVIDIAは汎用のCUDAコアからTensor Coreへ、より多くの仕事を移し、同じ面積に搭載する計算能力を増やそうとしてきました。両者の面積の配分はすでに逆転しています。Tensor Coreの面積はAmpereの頃にCUDAコアと肩を並べ、Hopperではおおむね5対4で上回り、Blackwellでは約2対1となっています。私たちの推計では、BlackwellのSM内で計算を担うシリコンの約3分の2が、行列乗算に使われています。Blackwell UltraとRubinはさらにこの方向を進め、Rubinでは低精度のTensor Coreの演算幅が再び2倍になります。これらの比率は私たち独自の推計であり、NVIDIAが開示している数値ではありません。以下の表は、世代ごとの推計を整理したものです。
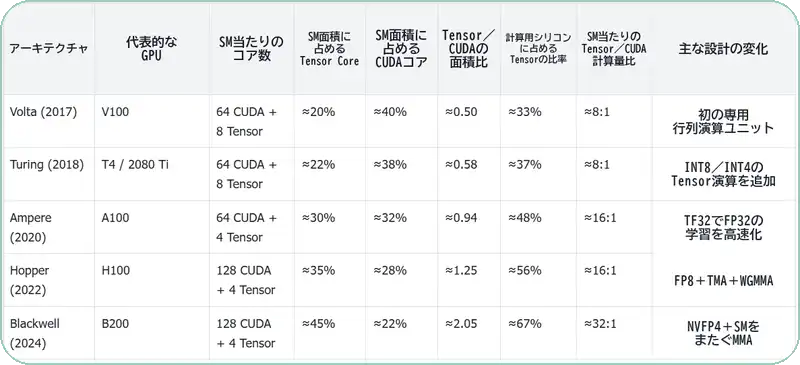
(出典: Convequityの推計。コア数はNVIDIAのアーキテクチャ資料)
「計算用シリコン」は、CUDAコアとTensor Coreの面積だけを数えています。計算量の比率は、SM当たり・1クロック当たりで、Tensor CoreのFP16処理量とCUDAコアのFP32処理量を比較したものです。最も低い精度では差がさらに広がり、BlackwellのB200で約128対1、Blackwell UltraのB300で約192対1、Rubinで約256対1となります。コア数はNVIDIAのアーキテクチャ資料に基づきます。
Blackwell UltraとRubinに表れた選択
Blackwell Ultraでは、この交換条件が仕様表に明確に表れました。ここでは製品名の区別が重要です。B200は最初のBlackwell GPU、B300はBlackwell Ultraです。両者は同じ二つのダイからなる設計と2,080億個のトランジスターを持ちますが、B300は単にB200を高速化したものではなく、配分を見直したチップです。GB200とGB300は、それぞれを基にしたGrace Blackwell製品で、NVIDIAのGrace CPU一つとGPU二つを組み合わせ、主にGPU72基のNVL72ラックとして販売されます。ラック内のGPUは、GPU8基のHGXサーバーに搭載される同じGPUより少し上の性能値に設定されているため、同じ構成同士を比較します。
最初のBlackwellチップを基にしたGB200のラックに対し、Blackwell Ultraを使うGB300のラックでは、低精度の密行列演算におけるTensor Coreの計算量が50%増えています。ここでの数値形式は、AI推論に使う4ビット形式のNVFP4です。一方、主に科学技術計算に使われる高精度のFP64と、INT8の処理量は約97%減りました。GPU8基のHGX B300サーバーとHGX B200を比較しても、同じ違いが見られます。NVIDIAはこれらの形式に割り当てるシリコンを削り、AIが使う低精度の行列演算と、アテンション向けの特殊機能の処理量を2倍にすることへ振り向けました。
Rubinは、この考え方をFP64自体にも広げます。専用のFP64ベクトル演算ハードウェアはGPU当たりでほぼHopperの水準へ戻りますが、公称のFP64行列演算の処理量はHopperの約3倍で、その処理はTensor Core上で模擬的に実現されます。NVIDIAのGPUは、NPUやTPUへ近づいています。基礎となる演算や計算ユニットが似てきて、異なる構造間の対応を付けやすくなるため、CUDAプログラムをカスタムASICへ移植するための労力も小さくなるでしょう。私たちは、CUDAによる防御の有効性は将来大幅に低下すると結論付けています。
【補足】数値精度と性能比較
FP64・FP32・FP16やNVFP4は、計算で数値を表す精度の違いです。本文の性能比には異なる精度での比較も含まれるため、その比率がすべての用途での速度差を意味するわけではありません。また、密行列の性能値と、ゼロの多いデータを利用する疎行列の性能値も区別が必要です。
制御回路に残る違い
ここでなお考えられる競争優位は、NVIDIAの多層的なスケジューラーの構造が、処理の調整機能を薄くしたAI専用チップと依然として異なる点です。基本的にNVIDIAの汎用GPUは、制御や実行順序の調整に、より多くのチップ面積を割いています。一方、TPUのようなチップは、この仕事をソフトウェアのコンパイラーへ移し、あらかじめ実行順序を決めます。チップ内の大きな制御機構が、実行時にその場で調整する方式とは異なります。その分、汎用GPUは本質的にプログラムを書きやすく、実験もしやすくなります。
2023年12月、私たちはファーウェイのAscendを「汎用GPUの技術的負債を持たずに作られた」と表現しました。NVIDIAはいま、自社のGPUを同じ方向へ設計し直すことで、その負債を減らしています。ただし興味深いことに、ファーウェイの側も、今後のAscend 950と960でCUDAコードをハードウェアへ対応付けやすくするため、GPUに似たSIMTの対応を加えています。
【補足】実行時の調整と事前の調整
コンパイラーは、プログラムをチップが実行できる形へ変換するソフトウェアです。どの処理をいつ行うかを事前に決める方式と、チップが実行中に調整する方式では、柔軟性と回路面積の配分が変わります。SIMTは、一つの命令で複数のスレッドを扱う実行方式を指します。
Pt.2で扱う論点
Pt.2では、ハードウェアの類似性に、AIによるコード生成とタイル言語の普及が重なることで、移植の障壁がどう変わるかを検討します。さらに、Broadcomのネットワーク・光通信の優位性と、NVIDIAにとって企業顧客の広がりが重要な理由を掘り下げます。