NVIDIAの予想PER16倍を問い直す Pt.2:AIによるコード移植とBroadcomの光通信が変える競争の構図
 コンヴェクィティ
■AIが移植と最適化を担う
AIによるコード生成とタイル言語の普及は、別の半導体へ移る負担を減らします。NVIDIAの世代間でも再調整が必要になるなか、筆者はCUDAの乗り換え障壁が弱まると見ます。
■Broadcomは接続で差別化
行列演算が同質化するほど、ネットワークや光通信部品が重要になります。筆者は高速SerDesとレーザー・DSPの供給力を評価し、Broadcomがシェアを広げると予想します。
■企業の導入経路が左右する
AIの利用がクラウドやモデル提供企業を通じて増えると、需要は仲介企業へ集まります。筆者は、その規模が専用チップの開発を促すため、NVIDIAには企業の直接調達が必要だと見ます。
■専用チップのソフト障壁低下
OpenAIの事例では、AIが書いた特定の演算コードが専門家のコードの1.5~1.8倍の速度を示しました。筆者は、移植後の性能改善もAIが担い、CUDAの強みが弱まると考えます。
※本記事は「Pt.1:推論への転換とGPUのNPU化」の続編です。GPUの内部構造がAI専用チップへ近づく変化を踏まえ、今回はソフトウェアの移植と、ネットワーク・光通信へ移る競争の焦点を検討します。
1. AIとタイル言語が変えるコード移植
コード生成の進歩が構造の変化を後押しする
AIが今どれほど上手にコードを書けるか、チップを実際に使えるようにする低レベルのソフトウェアも含め、その点にはまだ触れていませんでした。Pt.1のハードウェア構造の議論は、この能力を前提にしていません。しかし、両者は互いを強めます。CUDAの競争優位の多くは、AIの仕事がNVIDIA(NVDA)のハードウェアで動くよう、何年もかけて人手で調整してきたコードから生まれています。そして、それこそがコード生成エージェントの得意になりつつある仕事です。最近の一例では、Anthropicが一人のエンジニアと複数のコード生成エージェントを使い、アドバンスト・マイクロ・デバイセズ(AMD)のAIチップで推論システムを動かしました。新しいチップへコードを移植し、調整できるAIと、NVIDIAのGPUのNPU化が重なることで、CUDAの防御壁が崩れつつあります。
同じNVIDIAの世代間でも調整が増える
Tensor Coreの増加は、NVIDIAのGPUが汎用性を失い、ある世代向けに書いたコードを次の世代へ引き継ぎにくくなることも意味します。Hopperのように、Tensor Coreの仕事量がCUDAコアの16倍であるチップ向けにAIプログラムを設計したなら、その比率を前提に仕事を配分するでしょう。次のBlackwellでは、その比率が32倍に変わります。NVIDIAはさらに、コアの近くに専用メモリを加え、Tensor Coreの構造を変え、能力を引き上げることもあります。理論上、前世代向けに最適化したCUDAコードは新しいチップでも実行できます。しかし、新機能や増えたTensor Coreの資源を使わないため、性能は極めて低くなります。最も徹底して最適化したコードは、そのままではまったく引き継げません。Blackwellは、新しい命令群とTensor Memoryという専用メモリ領域でTensor Coreを制御します。その結果、トランスフォーマーモデルの中心にあるアテンション処理に最も広く使われているコード、FlashAttentionは、Blackwell向けに再び設計し直す必要がありました。
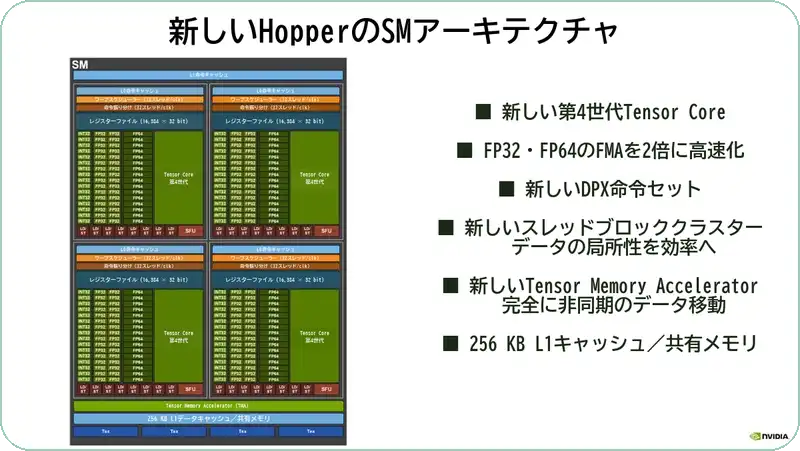
(出典: NVIDIA)
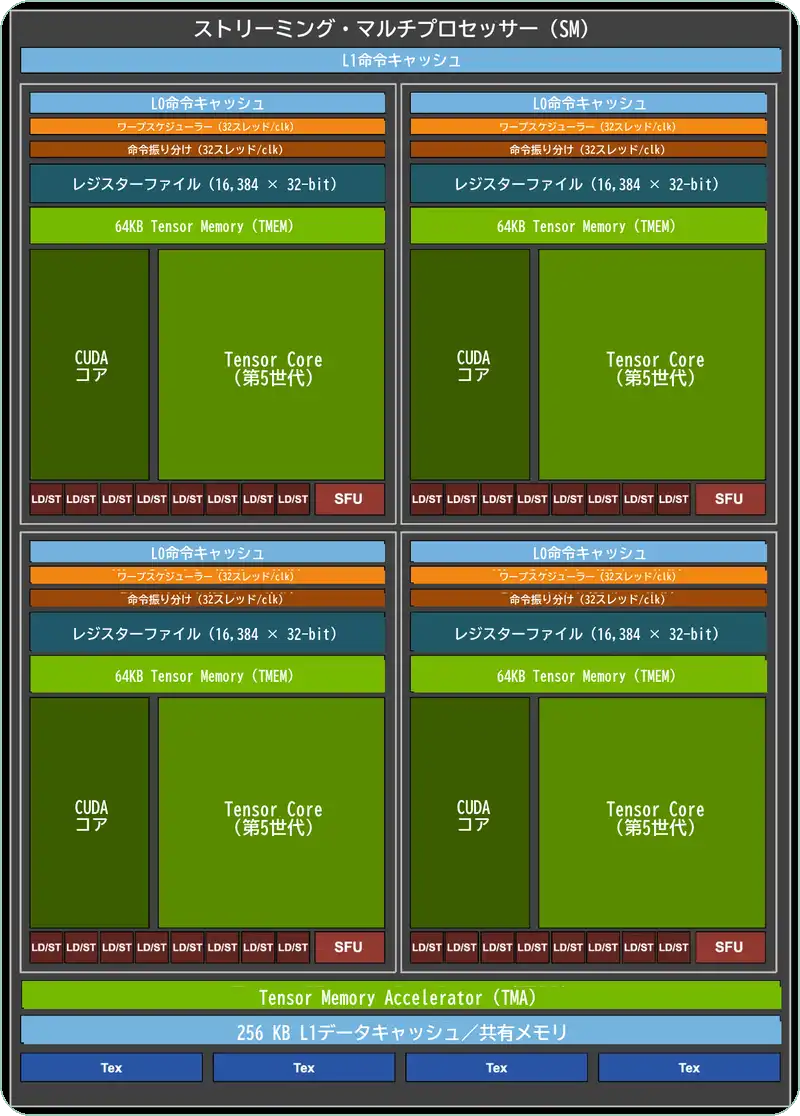
Blackwellの構造です。汎用のCUDAコアに比べて、第5世代のTensor Coreがどれほど大きな面積を占めるようになったかに注目してください。また、新たなTensor Memoryの層を活用するには、コードを書き直す必要があります。
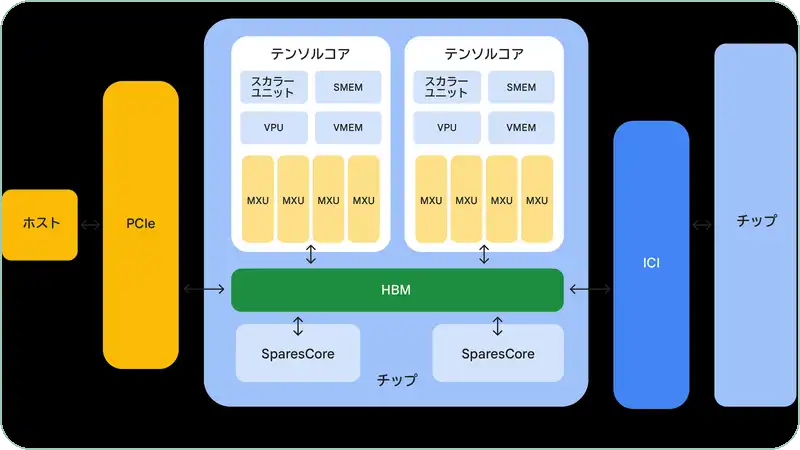
GoogleのTPU v7の構造です。行列演算ユニットはTensorCoreの内部にあり、TensorCoreはチップの高帯域幅メモリへ直接つながっています。一方、NVIDIAのGPUでは、Tensor Coreとメモリの間に、レジスターファイル、命令の振り分け装置、ワープスケジューラー、命令キャッシュなど、制御や実行順序調整のための複数の層があります。
開発者にとって、これは悪夢になりつつあります。NVIDIAの新しいGPU世代が登場するたびに、既存のAIや推論のコードをどう適応させ、再び最適化するかを考えなければなりません。私たちの見方では、その仕事は、同じコードを他社のカスタムAIチップへ移すための仕事に近づいています。両者の差が縮まっているのです。
【補足】動くことと効率よく動くこと
コードを実行できても、新しいチップのメモリや計算回路を十分に使えなければ、性能は出ません。本文は、同じメーカーの新世代へ最適化し直す負担と、別のメーカーへ移植する負担の差が縮まる、という筆者の見方を述べています。すべてのコードの移植が同じ難易度になったという意味ではありません。
CUDA Tileが示す転換
私たちにとって決定的だったのは、NVIDIAが新しい言語を発表したことです。2025年12月、同社はcuTile言語を伴うCUDA Tileを公開し、20年前にCUDAが生まれて以来、最大の変更だと説明しました。2026年を通じて、Ampere以降のすべてのGPU世代に対応を広げ、C++の対応も加えました。これは、NVIDIAがもはやCUDAコアを、コードを書く際の中心として扱っていないことを示します。従来のCUDAの方法は、Tensor Coreやその他のAI専用ユニットにうまく適合しないからです。新しい言語は、最新のTensor Core向けにコードを調整するときの複雑さを、プログラマーから隠します。CUDAという名前は残りますが、CUDAコアに結び付いたものではなくなっています。プログラマーはデータのまとまりであるタイル単位で仕事を記述し、コンパイラーが、与えられたGPUで最も適切に動かす方法を決めます。
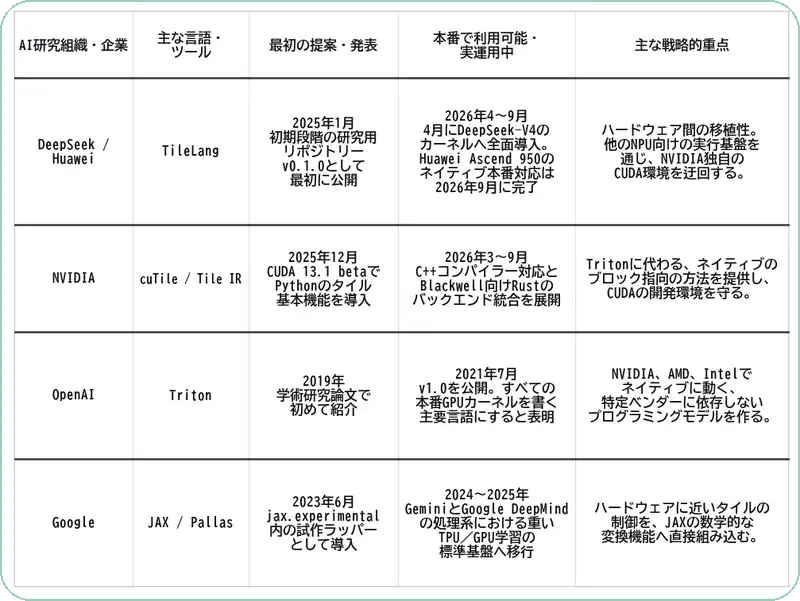
タイル言語で書かれたコードは、基礎となる計算ユニットがすでにかなり似ているため、他のAIチップへ容易に移せます。公開されたタイル言語では、すでにそれが進んでいます。9月30日、DeepSeekは、自社モデルを動かす低レベルのコードを書くために使う公開タイル言語、TileLangのAscend版を公開しました。学習で使うTileLangの演算がすべて、NVIDIAのGPUだけでなく、ファーウェイのチップでも効率よく動くようになっています。私たちは、これは大きなニュースでありながら、気付いている人が少ないと考えています。
AI研究者は以前からタイル言語を議論してきましたが、NVIDIAがこの方法を採用したのは最後でした。採用すればCUDAの防御力が弱くなると分かっているからです。しかし、ほかに選択肢はありませんでした。GPUの新世代ごとにTensor CoreとCUDAコアの配分が異なり、新しいTensor Coreには、専用メモリや制御機構など、旧世代にはない機能が加わります。ある世代へ直接対応させて書いたコードは、次世代ではますます機能しにくくなります。Tileのように抽象度の高い言語が、一度書いたコードをすべての世代で良好に動かす、唯一の現実的な方法なのです。
投資家は、この変化に十分な注意を払っていません。しかし、その意味は大きいと考えます。重要なコードがタイル単位で書かれるようになれば、NVIDIAの価格決定力を支える乗り換えコストは低下します。
【補足】タイル言語とコンパイラー
タイル言語では、個々の細かな計算指示より、データのまとまりに対する処理を記述します。コンパイラーは、その処理を対象チップの命令やメモリ配置へ落とし込みます。異なるハードウェアでも同じ考え方を使いやすくなりますが、各チップ向けの変換機能や性能調整は引き続き必要です。
2. BroadcomのカスタムASICが伸びる理由
大口顧客が専用チップを選ぶ経済性
Broadcom(AVGO)は、カスタムASICで非常に順調に進展しています。2023年12月の調査で論じたとおり、特に顧客の大半が巨大クラウド企業や大手AIモデル開発企業である場合、将来の中心はカスタムASICです。Broadcomの前四半期のAI売上高は167億ドルに達し、前年同期比221%増となりました。その前の四半期の143%増、さらにその前の106%増から加速しています。長期のカスタムアクセラレーター契約を結んだ後、確定契約の受注残を示す残存履行義務は、2月の450億ドルから8月には1,790億ドルへ増加しました。
NVIDIAの大口顧客であれば、コストを下げるためにカスタムASICを作ることを、なぜ考えないのでしょうか。売上高が例えば100億ドル未満なら、経済的に成り立たないかもしれません。しかし、500億ドル、1,000億ドル、さらには1兆ドルへ近づけば、必須になります。その規模の事業に初期設計費用を分散でき、チップの使い方によって、コストを少なくとも半分、場合によっては4分の1にできるからです。
差が付くのは計算より接続
最大の恩恵を受けるのはBroadcomです。GPUがNPUに近づくにつれ、各社の行列演算能力は同質化していきます。差別化の要因はネットワークです。学習と推論では数百、数千のチップを接続するため、ネットワークは解決が極めて難しい制約になります。
重要な制約の一つは、高速のSerDesです。私たちの見方では、224Gで実現できるのはNVIDIAとBroadcomだけです。そのため、カスタムASICを作るなら、Broadcomに向かうことになります。私たちは、意図的にマーベル・テクノロジー(MRVL)を投資対象として避けてきました。設計費用の少ない提携先が、全体でも低コストとは限らないからです。SerDesやネットワークで劣ると、導入後の費用が積み重なります。チップの初期設計費用を節約しても、システム全体の総保有コストや投資効率が、はるかに悪くなりかねません。アマゾン・ドット・コム(AMZN)とマイクロソフト(MSFT)はその教訓を得たと考えていますが、多くの投資家はまだ認識していません。
私たちは、Broadcomが今後も進展し、2027年、2028年、2029年のカスタムASIC売上高の会社見通しを大幅に上回ると予想しています。経営陣は、2027年度にAI売上高を再び倍増させて約1,150億ドルとするための供給を確保しており、2028年度には2,300億ドルを見通せるとしています。アルファベット(GOOGL)傘下Googleに加え、Anthropic、OpenAI、xAI、アップル(AAPL)、その他の大手顧客との契約を獲得しています。BroadcomはTPU v7で実現したように、実際に動くチップとクラスターで224GのSerDesを提供できる、NVIDIA以外で唯一の企業です。私たちは、OpenAIとAnthropicだけで、2026~2028年の累積需要が最大20GWに達すると予想しています。
【補足】SerDesとシステム全体のコスト
SerDesは、チップ間などで高速にデータを送受信するため、並列の信号と直列の信号を変換する回路です。チップ単体の計算が速くても、接続で待ち時間や電力消費が増えれば、システムの効率は下がります。総保有コストは初期の設計費用だけでなく、導入後に使い続ける費用も含めて考えます。
光通信部品が供給の主導権を変える
ネットワークはBroadcomの原点です。NVIDIAは計算を担う企業として始まり、Mellanoxの買収によってネットワーク能力を拡大しました。私たちは、NVIDIAのネットワークが最良だとは考えていません。光通信の知見不足が、同社の最大の弱点になりつつあります。それこそがBroadcomの最大の強みでもあります。2023年12月の時点では、ネットワークをNVIDIAの競争優位の一部と見なしながら、Broadcomを唯一の有力な代替企業に挙げ、実行力を発揮すると期待していました。同社はそれを実現しました。変わったのは制約の位置です。スイッチから光通信へ移りつつあります。
光トランシーバー向けのDSPやレーザーは不足しており、Broadcomは最良の製品と生産能力を持っています。ホック・タンCEOによると、レーザーの需要は供給を大幅に上回り、Broadcomは自社のレーザー生産能力を前年比で3倍超へ拡大しています。同社は、その供給枠を組み合わせて提供できます。2023年には顧客がNVIDIAへGPUの供給枠を求めなければなりませんでした。2023年12月のMSU分析で説明したように、その供給枠を得る代償は、ネットワークを含むNVIDIAのデータセンター基盤全体を購入することでした。いま顧客は、DSP、レーザー、関連部品を求めて、Broadcomやその他の光通信部品供給企業へ向かわなければなりません。
Broadcomは、カスタムASICの顧客に対して、優先出荷と光通信部品の供給能力を保証すると伝えられます。ASICへの支出がそれほど多くない顧客でも、その関係によって、NVIDIAのGPUと組み合わせて使うBroadcomのレーザーやDSPについて、より良い供給枠や値引きを得られる可能性があります。私たちは、これを強力な組み合わせ販売の戦略だと考えています。
これが、NVIDIAが3月にルメンタム・ホールディングス(LITE)とコヒレント(COHR)へそれぞれ20億ドル、マーベル・テクノロジーへ20億ドルを出資し、連携を築いている最大の理由です。これらはNVIDIAの能力が不足し、補強しなければならない領域です。私たちは、Broadcomが相対的な優位性を維持し、今後何年にもわたってNVIDIAからシェアを獲得すると予想しています。
【補足】光トランシーバーとDSP
光トランシーバーは、電気信号と光信号を変換してデータを送受信する装置です。レーザーは光を作り、DSPは信号処理を担います。本文は、計算チップの性能だけでなく、必要な光通信部品を十分に確保できることが、顧客の設計先選びにも影響するという議論です。
3. 企業のAI導入の停滞から公開モデルへ
成果が限られた企業に集中する
私たちは、企業全般へのAI導入はうまく進んでいないと考えています。企業がまったく成功していないという意味ではありません。Palantir(PLTR)はAIPを通じ、多くの企業によるAI導入を支援してきました。前四半期の米国商用部門の売上高は前年同期比149%増と、その前の四半期の133%増から加速しています。しかし、Palantirとその超大型の多国籍企業の顧客以外では、多くの成功事例が見られません。能力が、例外的に優秀な少数の組織へ集中したままであることを示しています。Palantirに加え、一部のAIアプリケーションの新興企業、とりわけコード生成の企業が該当します。法律などの専門領域で事業を展開するHarveyやLegoraのような新興企業は、まだ売上成長の初期段階です。最も成功している事例は、依然としてコード生成エージェントとPalantirです。
NVIDIAの立場から見れば、これを企業への導入の成功とは呼べません。主要なAI顧客は、依然として巨大クラウド企業と、OpenAIやAnthropicなどのモデル開発企業です。カスタムASICにシェアと利益率を奪われる流れから抜け出すには、顧客基盤を多様化し、より多くの企業がNVIDIAの計算能力を直接購入するようにする必要があります。それらの企業は、自社の専用チップを作る費用を負担するには規模が小さすぎます。だからこそ、企業への導入拡大がNVIDIAの最優先課題なのです。
顧客が誰を通してAIを使うか
ジェンスン・フアンCEOが、デル・テクノロジーズ(DELL)を頻繁に取り上げるのも、このためです。デルは企業との幅広いつながりを持ち、フアンCEOはその販売経路を通じて、より多くの企業へ販売する計画でした。私たちは、それが特にうまく機能したとは見ていません。デルは主にNVIDIAとの関係を使ってGPUの供給を増やし、自社の売上高と利益率を拡大してきました。NVIDIAが開拓を期待した、より小規模な企業市場を開く役割は十分に果たしていません。NVIDIAに必要なのは、企業自身が同社の計算能力の購入者になる形でのAI導入です。
企業が巨大クラウド企業、Anthropic、OpenAI、その他の非公開モデルの提供企業を通じてAIアプリケーションを作るなら、需要はその仲介企業へ集中したままです。仲介企業は顧客の売上と仕事を集約し、カスタムASICを追求するのに十分な規模を得られます。そのチップが計算コストを半分や4分の1に下げれば、利用はさらに広がり、NVIDIAへの需要は一段と減ります。NVIDIAは企業顧客を自社の計算能力へ直接つなぐ必要がありますが、その進展は非常に遅いと考えています。
ほとんどの企業は、今もクラウドや非公開モデルを通じてAIを使っています。Palantirの費用を負担できる企業の一部は、同社の基盤を使います。企業がNVIDIAのGPUクラスターを調達し、自社設備内で独自の推論環境とアプリケーションを構築する例は、依然としてまれです。クラウドや非公開モデルを経由する使い方は、仲介企業がカスタム半導体を開発する動機を保つため、NVIDIAの将来にとって非常に不利です。
【補足】AI需要の増加とGPUの販売先
AIの利用が増えても、その計算をまとめて提供する企業が専用チップへ移れば、NVIDIAのGPU需要が同じ割合で増えるとは限りません。本文は、最終利用者の数だけでなく、計算基盤を調達・設計する意思決定が、どの企業へ集まるかに注目しています。
4. AIが演算コードを最適化する時代
CUDAのライブラリーが築いてきた強み
大規模言語モデルが演算の最適化を上手に行えるようになることでも、CUDAの競争優位は崩れつつあります。これは大きなニュースですが、まだ多くの投資家が気付いていません。演算とは、二つの行列を掛けたり、文中のどの単語へ注意を向けるかを決めたりする、AIモデルが何度も繰り返す基本的な処理です。それぞれの演算には、チップに実行方法を細かく指示するコードが必要です。そのコードの出来が、モデルの速度を左右します。AIモデルは以前からコード生成を得意としていましたが、CUDAの競争優位の基礎をなすこうした演算の最適化には、それまで十分な能力がありませんでした。
NVIDIAの強みは、プログラムの柔軟性だけではありません。膨大な種類の処理を事前に用意し、開発者がすべてを自分で最適化しなくても、多くのアルゴリズムが自社のハードウェアで効率よく動くようにしてきました。NVIDIAは、高速化のためのライブラリー、特にcuDNNへ多額の資金と技術開発の労力を投入しました。
いま、Anthropic、OpenAI、DeepSeekなどの主要な開発企業が、自社モデルの実行に使う演算を、そのモデル自身で改善する例が増えています。私たちは、これがはるかに一般的になると考えています。まず、GPUを使い続ける顧客であっても、モデルに優れた演算コードを書かせ、自社のソフトウェア群を開発し、最適化できるようになります。
専用チップへ移した後の性能もAIが改善する
さらに大きな意味を持つのは、カスタムASICです。その所有者は、NVIDIAがかつて人手でライブラリーを最適化するために必要としたような、巨大なソフトウェア技術者のチームを雇う必要がなくなります。専用チップを作り、自社モデルに、そのチップ向けの非常に効率的な演算コードを書かせられます。
専用チップで実証されたコード生成
Jalapeñoにおける演算性能と移植期間
OpenAIは、このことを実際に示したばかりです。8月のHot Chipsで、Broadcomが手がけた同社のチップ、Jalapeñoを発表しました。社内版のCodexが、OpenAIのカーネル技術者による介入なしに、各演算を実行する効率的なカーネルを記述しました。現在のモデルで特に重要な二つの演算であるアテンションと、複数の専門モデルを組み合わせるMoEについて、そのコードは人間の専門家が書いたものより1.5~1.8倍速く動作しました。さらにOpenAIは、最初に動作するチップを受け取ってから約3カ月で、他社がこのチップを想定せずに作った、重みが公開されたモデル三つをJalapeño上で動かしました。通常、既存のモデルを新しいチップで動かすには、まず実行用のソフトウェアを書く必要があるため、はるかに長い時間がかかります。今回は、その多くをAIが書いたのです。
【補足】演算とカーネル、公開されたモデル
演算は「行列を掛ける」といった処理そのもの、カーネルはその処理を特定のチップ上で実行するコードです。モデルの重みが公開されていれば別の計算基盤で動かす選択肢が広がりますが、利用条件や必要なソフトウェアは個別に異なります。本文の1.5~1.8倍は、挙げられた演算コードの比較です。
2023年の評価を変える要因
2023年12月、私たちはGoogleのTPUについて、「ほとんど勝ち目がない」と論じました。ソフトウェアで動作を決める構造が、複雑さをコンパイラーと開発者へ押し出すからでした。TPUでは、用意されたライブラリーやチップ自身に任せる代わりに、開発者が演算コードを書き、調整する仕事を、より多く担います。いまモデルが開発者の手から引き受けつつあるのは、まさにその仕事です。
私たちは、これによってNVIDIAのCUDAの防御壁の別の部分も崩れると考えています。問題は、単にコードを移植しやすくすることではありません。移植したコードを、NVIDIAのCUDA環境なしで効率よく動かせるようにすることです。投資家は、依然としてこの帰結に十分な注意を払っていません。